English

Van ruwe data naar software die werkt.

Ik ben Koen Dercksen, AI-engineer en full-stack developer. De meeste projecten beginnen met rommelige data: e-mails, verslagen, artikelen, webpagina's. Ik bouw de software die daar informatie van maakt waar uw team mee verder kan.

Aanvraag per e-mail

Goedemiddag, mijn naam is Mark de Vries, geboren 14-02-1984, Kerkstraat 12, Utrecht. Sinds 2019 heb ik De Vries Klussen en ik wil graag een Volkswagen ID. Buzz Cargo van € 54.000 leasen over 60 maanden. Vorig jaar was onze omzet ongeveer € 310.000.

  1. Pseudonimiseren voordat het model het ziet

    Mijn naam is ‹PERSOON_1›, geboren ‹DATUM_1›, ‹ADRES_1›. Sinds 2019 heb ik ‹BEDRIJF_1› …

  2. Feiten extraheren

    Leeftijd bedrijf
    7 jaar
    Voertuig
    Elektrische bestelbus
    Leasebedrag
    € 54.000
    Omzet
    € 310.000
  3. Beleidsregels toepassen

    • Bedrijf ouder dan 3 jaar
    • Leasebedrag onder 25% van de omzet (17%)
    • Controle kredietregister loopt nog

    Klaar voor de beoordelaar, met één open controle

Gebaseerd op echte projecten. De gegevens in deze voorbeelden zijn verzonnen.

Vaste klanten

Met een paar bedrijven werk ik langdurig samen. Ik maak deel uit van hun team en bouw hun AI-platforms, van de eerste versie tot in productie.

  • Rol: Tech lead
  • Sinds 2026

Trackbase

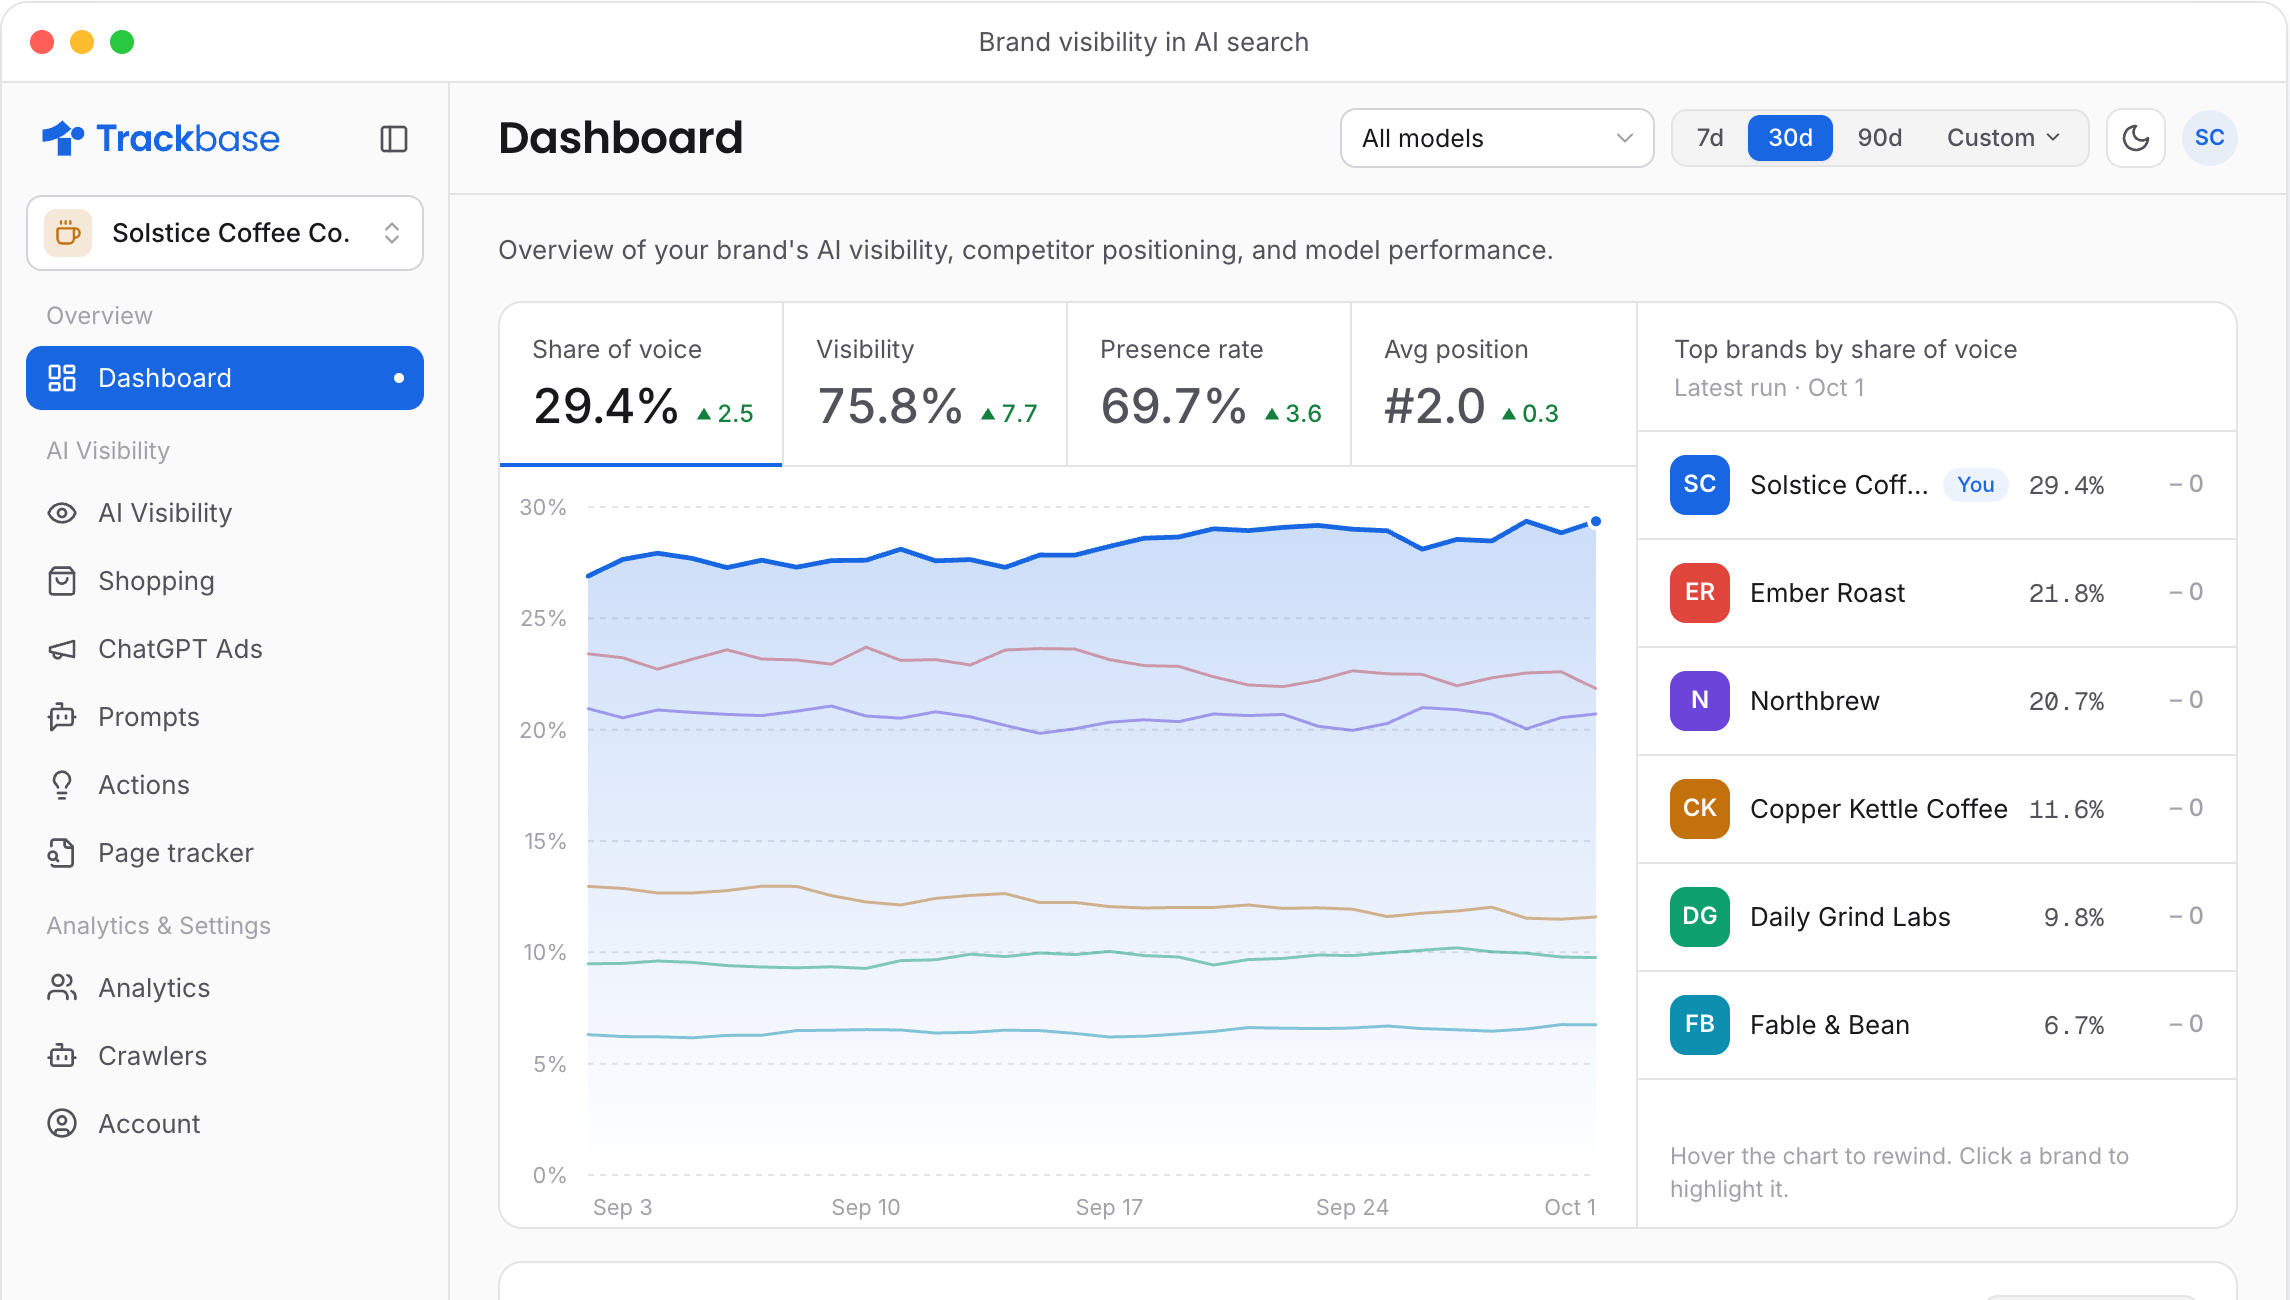
Trackbase toont wat AI-assistenten klanten over een merk vertellen.

Elke dag legt het platform vragen van klanten voor aan ChatGPT, Claude, Gemini en andere assistenten. Het laat zien of ze een merk noemen, hoe het merk scoort tegenover concurrenten en op welke bronnen de assistenten zich baseren.

  • Geplande promptruns op meer dan 10 AI-engines, met analyse van vermeldingen, posities, concurrenten en bronnen.
  • Analyse van AI-crawlers en AI-verwijzingen, op basis van een trackingscript en CDN-logs.
  • Een insights-engine die ruwe modeluitvoer omzet in aanbevelingen met een score.
  • Multi-tenant accounts voor bureaus, abonnementen en een MCP-server met OAuth.
Ga naar trackbase.ai

Het Trackbase-dashboard met share of voice, zichtbaarheid en positie tegenover concurrenten voor een fictief koffiemerk.
  • Rol: CTO
  • Sinds 2024

World Brain Scholar

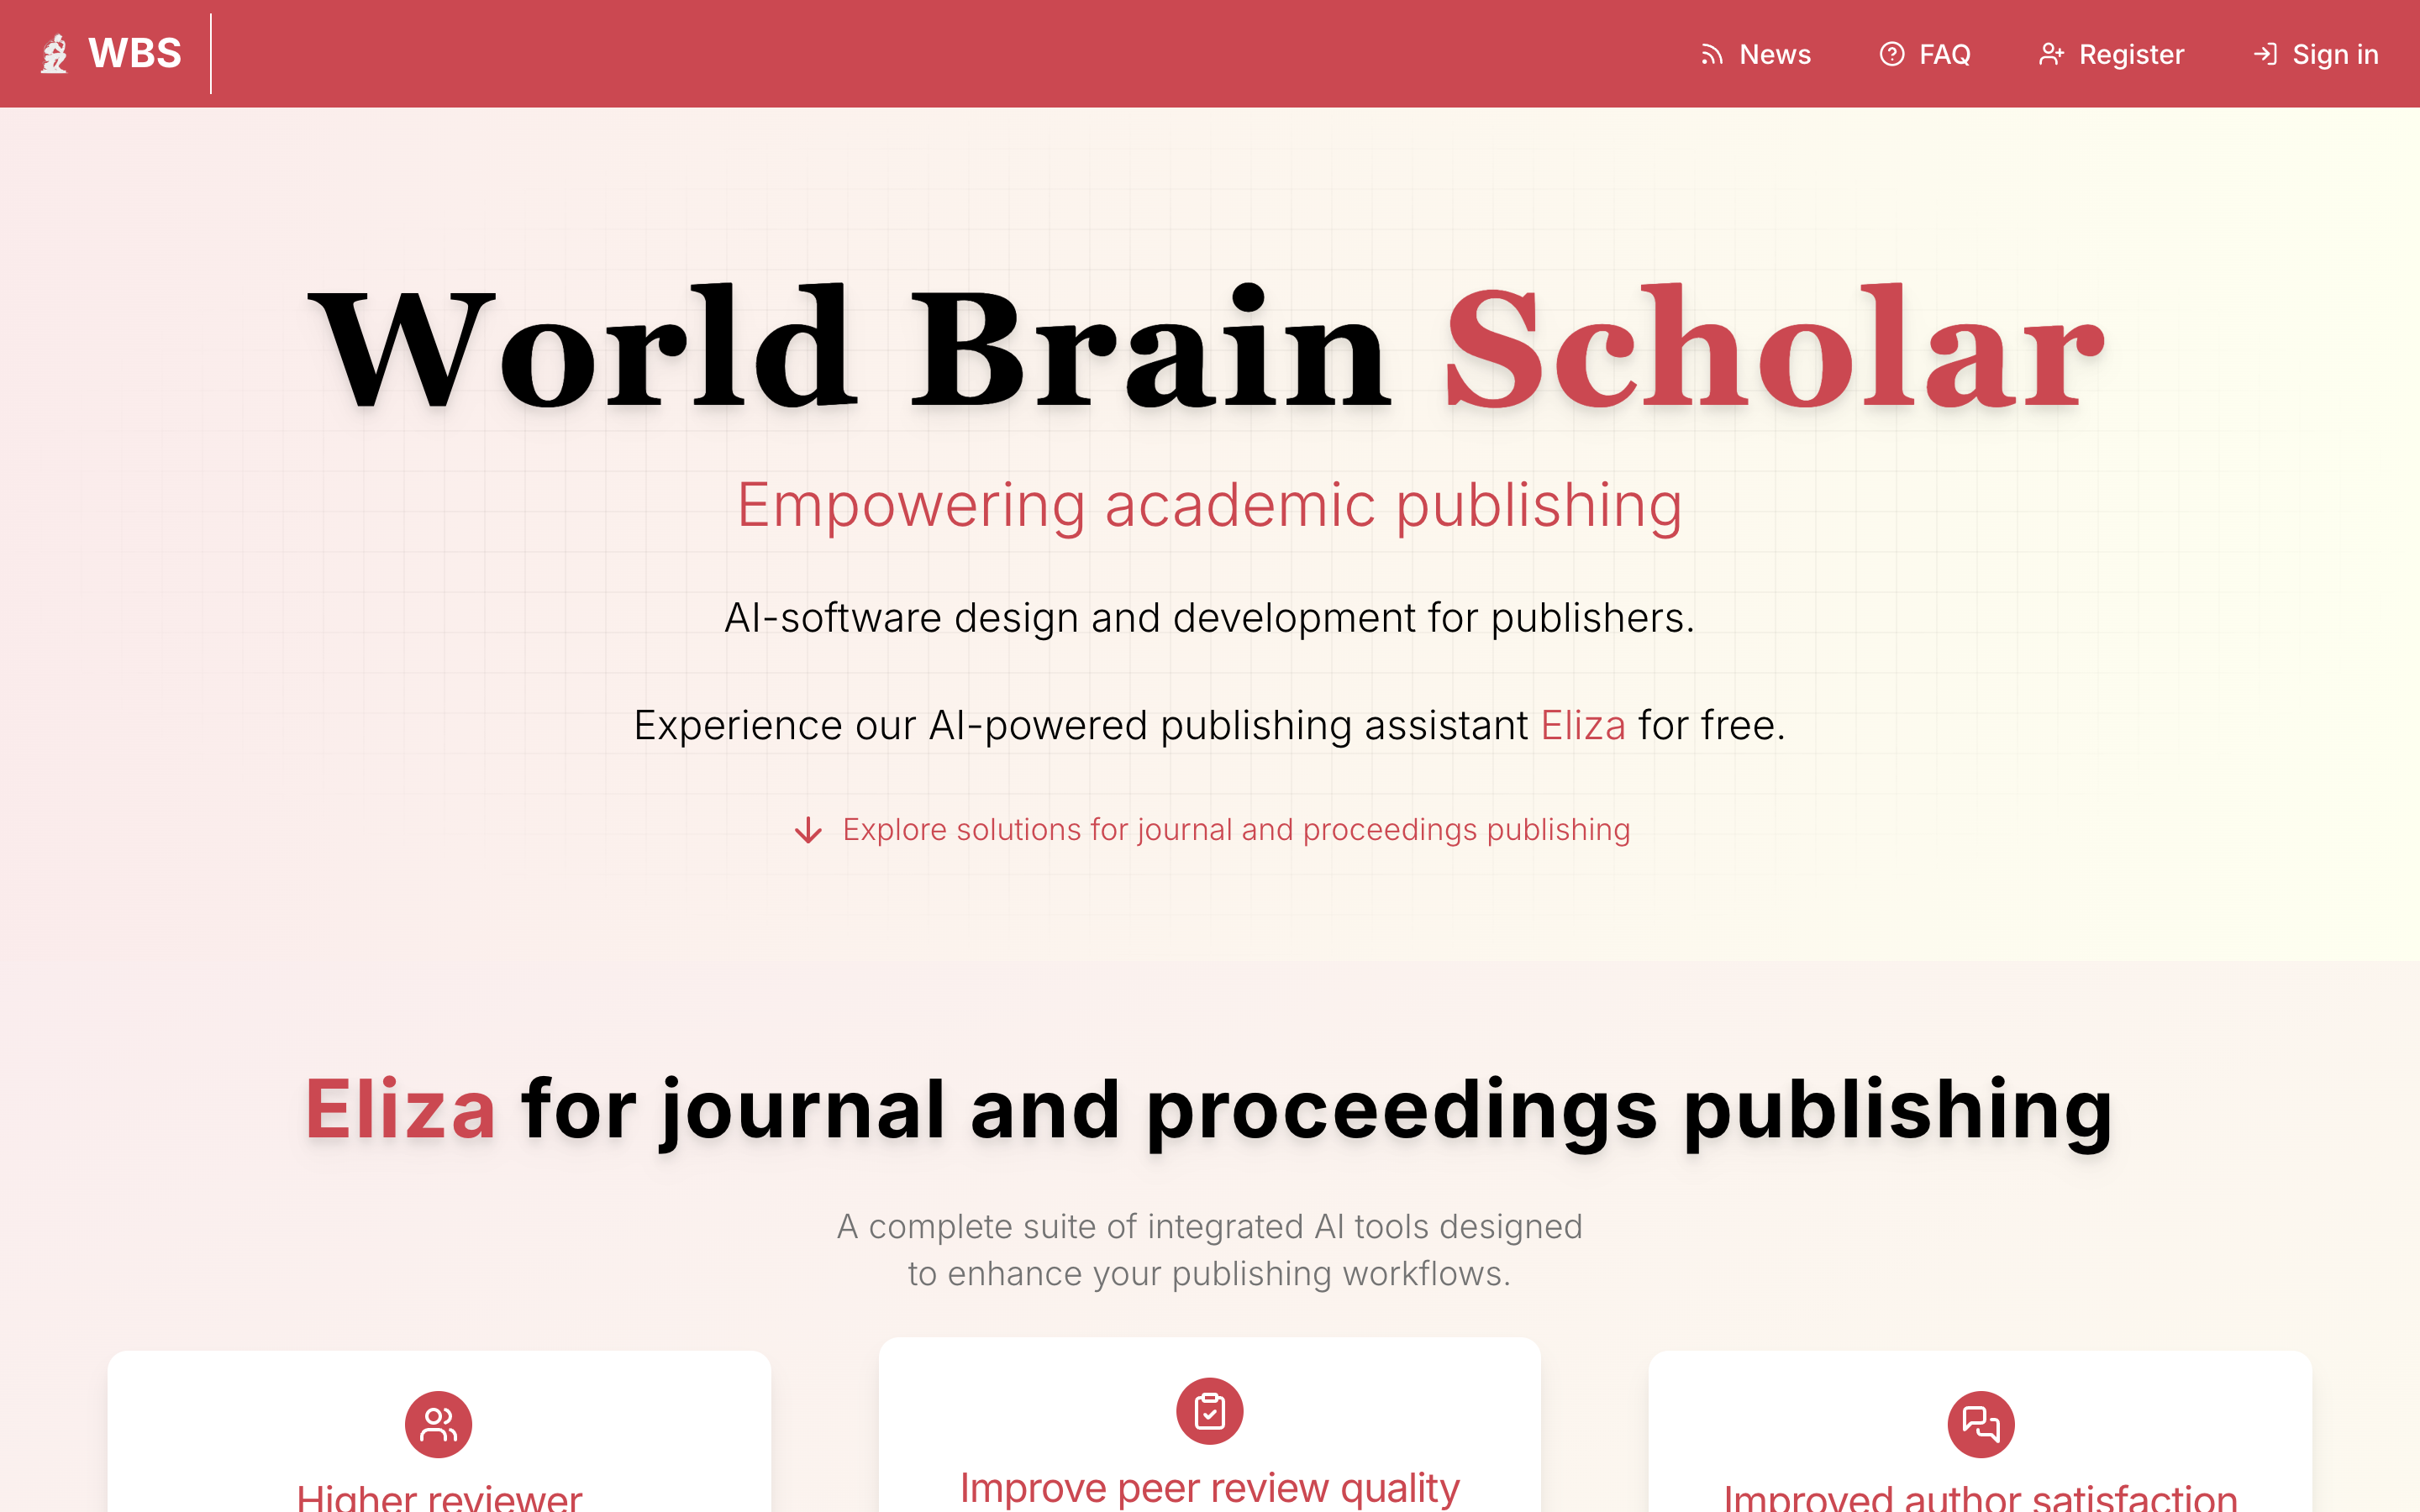
World Brain Scholar bouwt AI-software voor wetenschappelijke uitgevers.

Het belangrijkste product is Eliza, een AI-assistent voor peer review. Eliza helpt redacteuren en reviewers bij het analyseren van manuscripten en in het reviewproces.

  • Ik heb Eliza ontworpen, gebouwd en in productie gebracht.
  • Een pipeline leest elk geüpload artikel, haalt de metadata eruit, berekent embeddings en vult aan met gegevens uit OpenAlex.
  • Eliza ondersteunt reviewers en redacteuren met een analyse van elk manuscript.
  • Als CTO ben ik verantwoordelijk voor de technische strategie en de productontwikkeling.
Ga naar world-brain-scholar.eu

De homepage van World Brain Scholar, met een introductie van Eliza, de AI-assistent voor uitgevers.

Klantprojecten

Mijn klanten hebben meestal veel ruwe data, waar hun teams elke week uren aan kwijt zijn. Hier zijn acht recente projecten; de namen van de klanten laat ik weg.

  • Brongegevens
  • AI-stap
  • Resultaat
  • B2B-leverancier
  • 2026

Expertartikelen voor de blog, in veel talen

De klant wilde regelmatig expertartikelen op de website, in veel talen. Een blogengine kiest een onderwerp, zoekt het uit op het web, schrijft het artikel met bronnen, controleert het en vertaalt het. De engine maakt ook de afbeeldingen en zet het artikel in het CMS. Een redacteur keurt elk artikel goed voordat het online gaat.

  • Na de eerste versie heb ik gewerkt aan het bronnenonderzoek van de engine, de schaal en de levering aan het CMS.
  • Elk artikel heeft bronnen die de lezer kan nagaan. Zonder bronnen komt een artikel er niet door.
  • Validatiestappen controleren de structuur, de merkregels en de feitelijke claims voordat het artikel wordt geleverd.
  • Een wachtrij stuurt elk artikel naar het CMS en probeert het opnieuw als het CMS een fout geeft.
  1. OnderwerpprofielWebbronnen
  2. Artikel schrijven met bronnen
  3. Feiten en structuur controleren
  4. Vertalen en afbeeldingen maken
  5. Artikel in het CMS, klaar voor goedkeuring
  • Leasemaatschappij
  • 2026

Eerste beoordeling van leaseaanvragen

Vroeger las en controleerde een medewerker elke aanvraag met de hand. Nu leest het systeem het dossier, raadpleegt het de krediet- en bedrijfsregisters en maakt het een eerste beoordeling voor de beoordelaar. De taalmodellen zien nooit gegevens waarmee een klant te herkennen is.

  • Persoonsgegevens worden vervangen door pseudoniemen voordat een model ze ziet, en elke herleiding wordt gelogd.
  • Het besluit komt uit een vaste set regels die los staat van het taalmodel, zodat een auditor ze kan controleren.
  • Beoordelaars passen de beleidsregels zelf aan, met een volledige geschiedenis van elke wijziging.
  • De beoordelaars besparen naar schatting 60 tot 80% van het werk per aanvraag.
  1. SharePoint-dossierKrediet- en bedrijfsregisters
  2. Pseudonimiseren
  3. Feiten extraheren
  4. Beleidsregels toepassen
  5. Eerste beoordeling voor de beoordelaar
  • Investeringsmaatschappij
  • 2026

Leads verrijken en scoren

Het salesteam was elke ochtend uren bezig met onderzoek naar bedrijven voordat het wist wie het moest bellen. Nu verzamelt het platform openbare gegevens per bedrijf, zoekt een taalmodel het bedrijf op het web uit en krijgt elke lead een score en een korte notitie met bronnen.

  • Koppelingen met bedrijfsregisters, insolventieregisters, aanbestedingen en nieuws.
  • Een wachtrij op de achtergrond verrijkt en scoort nieuwe leads automatisch.
  • Het team controleert elke notitie en stuurt de goedgekeurde leads naar het CRM.
  1. BedrijfsregisterAanbestedingenNieuws
  2. Verrijken
  3. Webonderzoek met bronnen
  4. Score en notitie
  5. Export naar CRM
  • Softwarebedrijf
  • 2026

Een wachtrij voor gedeelde GPU-machines

Een team van engineers en onderzoekers deelde een handvol GPU-machines en sprak in een groepschat af wie welke machine kreeg. Nu zet iedereen een Docker-job in een wachtrij, die de job start op een machine met vrije capaciteit. Een webinterface toont de wachtrij, de logs en hoe druk elke GPU is.

  • Jobs worden verdeeld op basis van het GPU-geheugen dat ze nodig hebben, zodat kleine jobs een GPU kunnen delen en er minder GPU-tijd verloren gaat.
  • Elke job draait als de persoon die hem heeft ingediend en kan alleen bij de mappen die de regels toestaan.
  • Gebruikers kunnen een shell openen in hun job. Een job kan ook een modelserver starten voor andere jobs; die stopt zodra die jobs klaar zijn.
  • Ook coding agents kunnen jobs indienen en resultaten lezen, via een MCP-server.
  1. Docker-job van een teamlidVrije capaciteit per machine
  2. Machine kiezen
  3. Job draaien als de eigenaar
  4. Logs en GPU-gebruik in de webinterface
  • Softwarebedrijf
  • 2026

Lokale taalmodellen, alleen als het team ze nodig heeft

Het team wilde taalmodellen gebruiken zonder data naar een externe aanbieder te sturen. Maar een model op een lokale GPU houdt een groot deel van het GPU-geheugen bezet, ook als niemand het gebruikt. Nu heeft het team één API voor alle lokale modellen. Een agent op elke GPU-machine start een model bij het eerste verzoek en stopt het na een uur zonder verzoeken. Dan is de GPU weer vrij voor ander werk.

  • Eén OpenAI-compatibele API voor alle lokale modellen, waar teamleden hun chat- en codeertools aan koppelen.
  • Een dashboard toont welke modellen draaien, en beheerders kunnen elk model starten en stoppen.
  • De modellen draaien op GPU-machines die het bedrijf al heeft. Er gaat geen data naar een externe aanbieder.
  1. Verzoek uit een chat- of codeertool
  2. Gedeelde API
  3. Model starten als dat nodig is
  4. Antwoord van het lokale model
  • Financiële dienstverlener
  • 2025

Automatische nieuwscontrole voor elke klant

Medewerkers zochten met de hand naar nieuws over elke klant. Nu verzamelt een geplande taak elke nacht artikelen, koppelt ze aan de klantenlijst en classificeert ze. 's Ochtends ziet het team alleen wat ertoe doet, zoals een faillissement.

  • Elke nacht haalt de taak artikelen op uit veel nieuwsbronnen.
  • De taak markeert faillissementen en andere belangrijke gebeurtenissen en filtert gewoon nieuws eruit.
  • Het team leest nu elke ochtend één korte lijst in plaats van urenlang te zoeken.
  1. Nieuwsbronnen, elke nacht
  2. Koppelen aan de klantenlijst
  3. Gebeurtenis classificeren
  4. Ochtendlijst met belangrijke berichten
  • Financiële dienstverlener
  • 2025

Een eigen AI-werkomgeving met meerdere agents

Het team wilde AI-assistenten die geen gegevens naar een openbare chatapp sturen. Nu is er een zelf gehoste chatomgeving met gespecialiseerde agents, plus een aparte API-laag die het gebruik logt en antwoorden in een cache bewaart.

  • Een zelf gehoste chatomgeving met agents voor verschillende taken.
  • Een API-laag tussen de agents en de modelaanbieders die het gebruik logt en antwoorden cachet.
  • Alles draait op infrastructuur die de klant al had.
  1. Vragen en documenten van het team
  2. Gespecialiseerde agents
  3. Laag voor logs en cache
  4. Antwoorden in de eigen omgeving van de klant
  • Investeringsmaatschappij
  • 2025

Een persoonlijke openingszin in elke nieuwsbrief

De klant stuurt een nieuwsbrief naar zakelijke contacten, en een algemene opening krijgt weinig aandacht. Nu krijgt elk contact een korte, persoonlijke openingszin die verwijst naar een recente LinkedIn-post van de persoon of het bedrijf, of naar het laatste e-mailcontact.

  • De tool haalt de contactenlijst en bedrijfsgegevens uit het CRM.
  • Hij zoekt recente LinkedIn-posts van elke persoon en elk bedrijf.
  • Een taalmodel schrijft per contact één of twee zinnen, in de toon van de klant.
  1. Contactenlijst uit het CRMLinkedIn-postsLaatste e-mailcontact
  2. Relevant onderwerp vinden
  3. Openingszin schrijven
  4. Persoonlijke opening in elke nieuwsbrief

Eigen producten

Daarnaast bouw en beheer ik een paar eigen producten.

evoicely

Geldige e-facturen van uw Stripe-facturen.

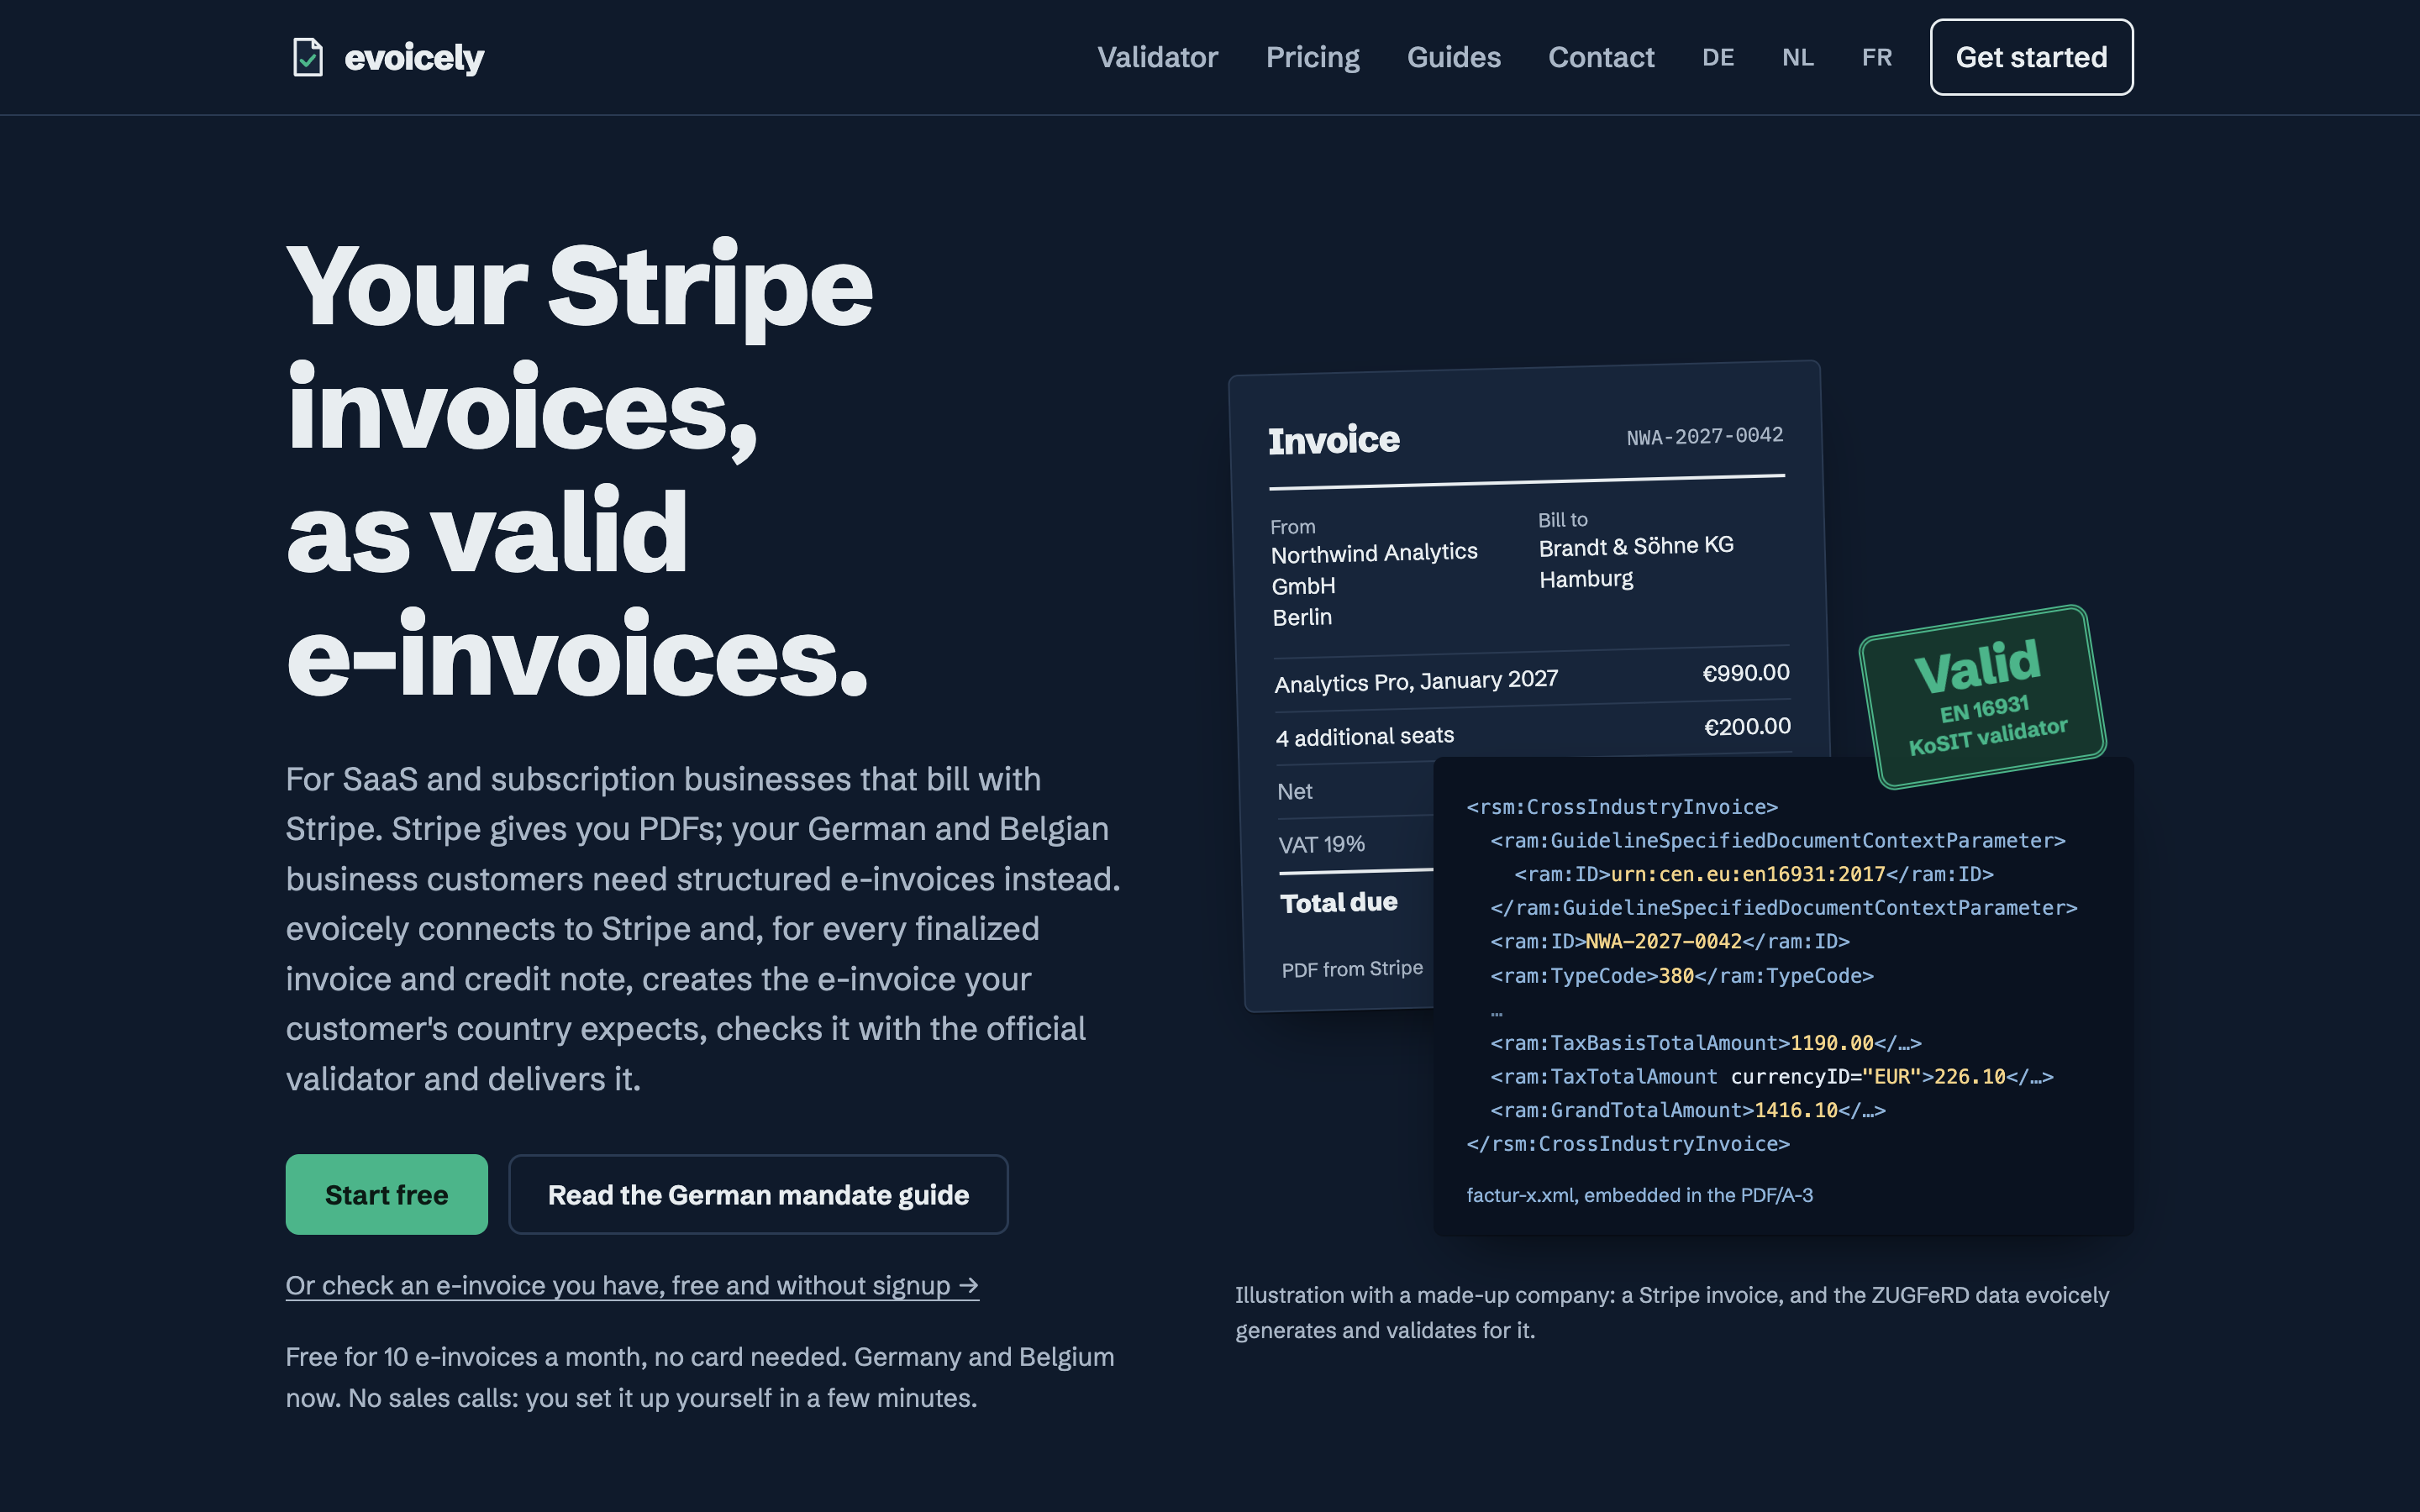
Zakelijke klanten in Duitsland en België moeten gestructureerde e-facturen ontvangen; een pdf is niet genoeg. evoicely koppelt met Stripe, maakt voor elke definitieve factuur de juiste e-factuur, controleert die met de officiële validator en verstuurt hem.

Ga naar evoicely.com

De homepage van evoicely, met een Stripe-factuur en de bijbehorende ZUGFeRD-gegevens.

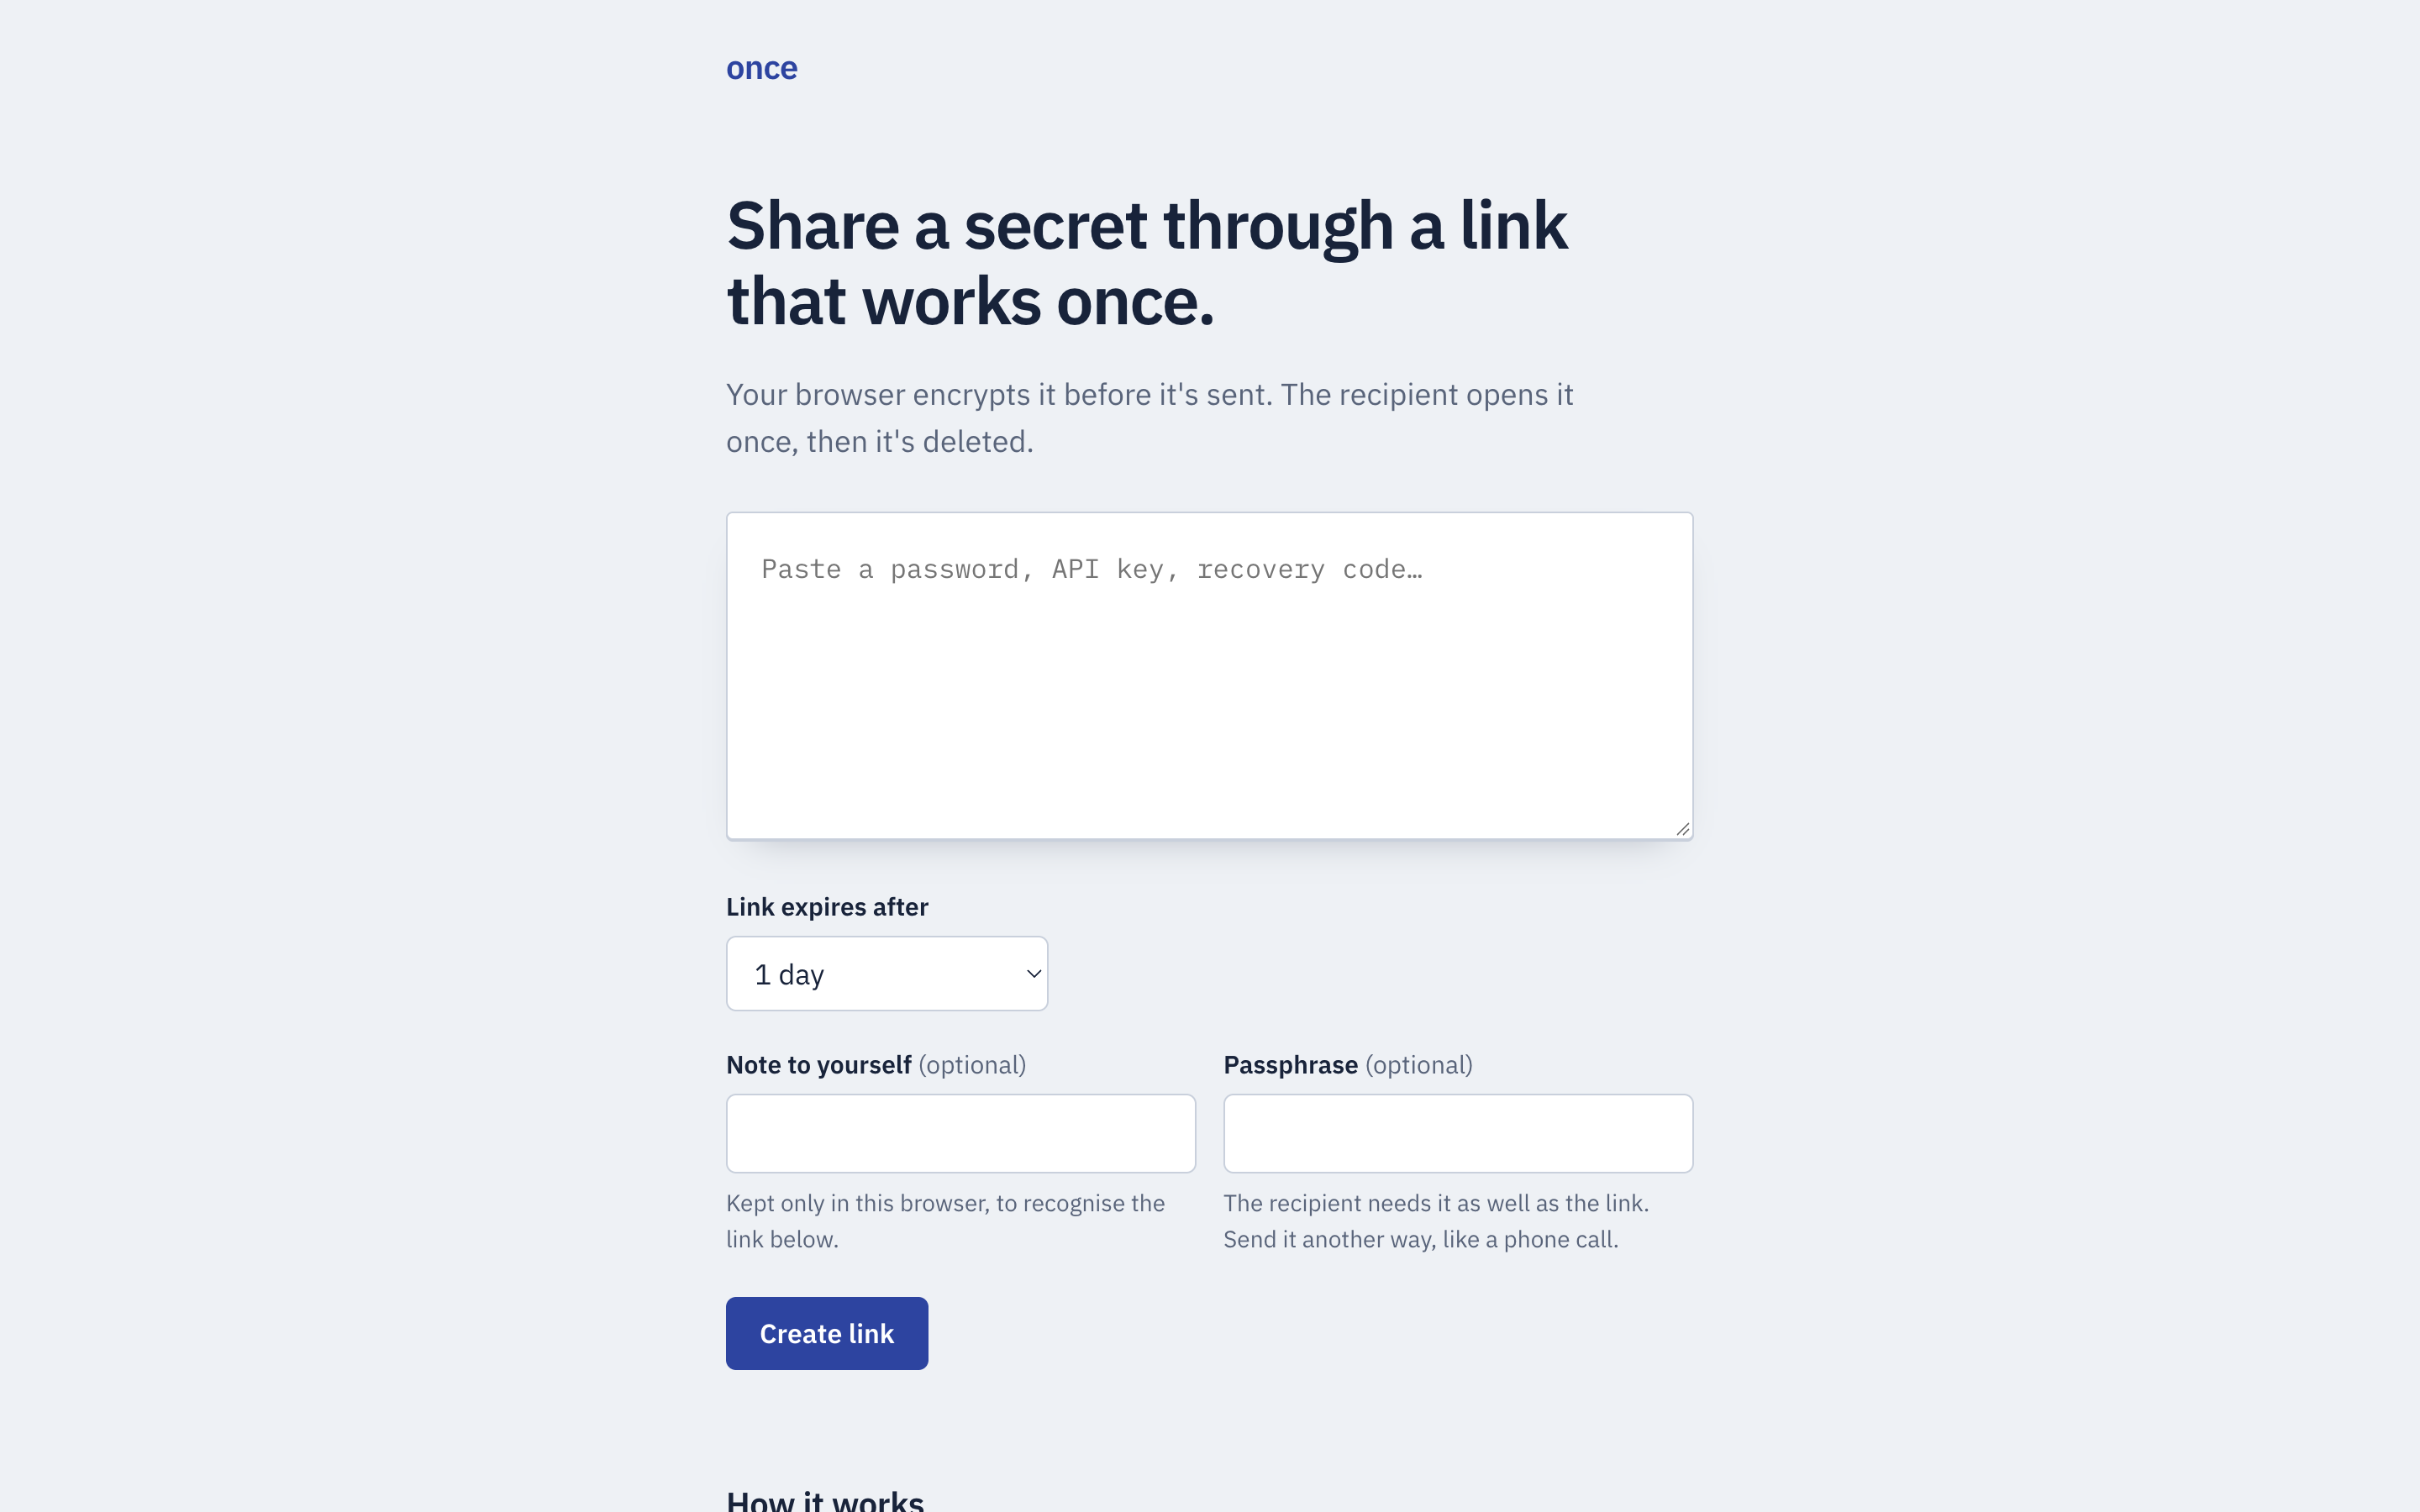
once

Deel een geheim via een link die maar één keer werkt.

Plak een wachtwoord of API-sleutel in het veld en stuur de link. Uw browser versleutelt het geheim voordat het vertrekt, dus de server bewaart alleen versleutelde gegevens. Zodra de ontvanger de link opent, wordt het geheim gewist. once is gratis en u hebt geen account nodig.

Ga naar once.avirai.com

De pagina van once, met een veld voor het geheim en een knop die de link maakt.

Recente artikelen

Korte artikelen over AI, data en beveiliging, voor teams die AI in hun dagelijkse werk willen gebruiken. Elk artikel vermeldt zijn bronnen.

Alle artikelen

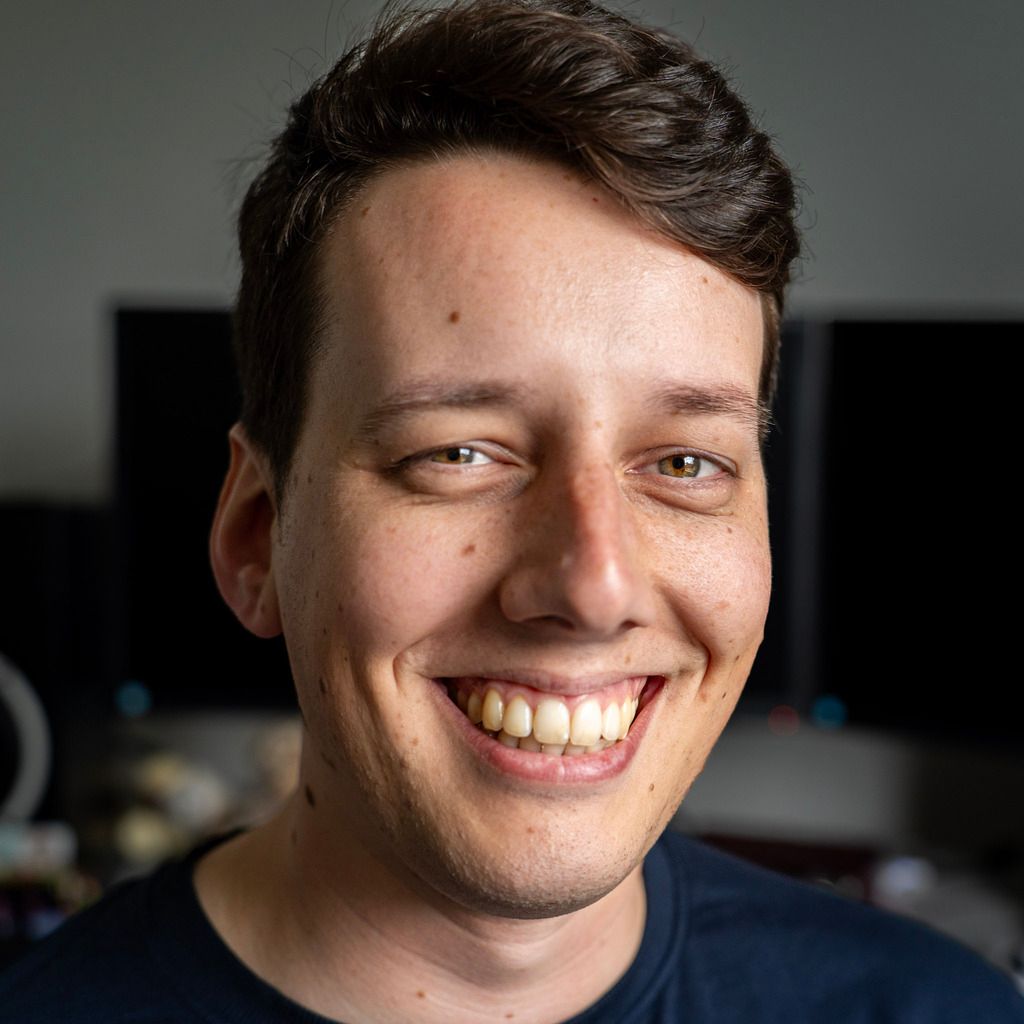
Foto van Koen Dercksen

Over mij

Hallo, ik ben Koen.

Voor mijn promotieonderzoek aan de Radboud Universiteit werkte ik aan natural language processing voor radiologieverslagen, met als doel die verslagen begrijpelijker te maken voor patiënten.

Nu ben ik senior engineer bij Plain Medical, waar ik aan medische tekst werk. Daarnaast ben ik CTO van World Brain Scholar.

Ik houd avirai bewust klein: een paar klantprojecten tegelijk, elk van begin tot eind. Ik zoek uit waar AI uw team tijd bespaart, bouw het systeem en houd het draaiend in productie. En u hebt direct contact met degene die de code schrijft.

Locatie
Nijmegen
Talen
Nederlands en Engels
Opleiding
Promotieonderzoek in NLP, MSc Data Science, BSc AI

Vertel over uw project

Beschrijf het probleem in een paar zinnen: wat voor organisatie u bent, welke taken te veel tijd kosten en wat u al hebt geprobeerd. Ik reageer per e-mail.

U hoort binnen één werkdag van mij. Het eerste gesprek is gratis en vrijblijvend, en ik teken graag eerst een NDA.

Of mail direct naar info@avirai.com.

Ik gebruik deze gegevens alleen om u te antwoorden. Lees de privacyverklaring.